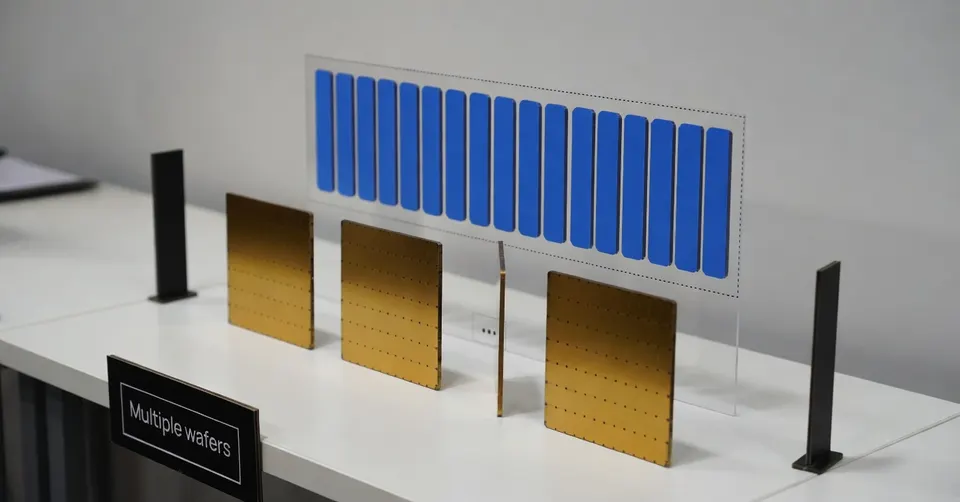
Cerebras verdeelt zeer grote AI-modellen over meerdere WSE-3T-wafers. Het bedrijf gebruikt het open-source model Kimi K3 als voorbeeld. Dat model heeft ongeveer 3 biljoen parameters en kan volgens Cerebras met deze aanpak worden uitgevoerd met snelheden van 1000 tot 2000 of meer tokens per seconde.
Elke WSE-3T-wafer beschikt over 44 GB aan geheugen op de chip. Dat is onvoldoende om een model met biljoenen parameters op één chip te plaatsen. Cerebras rekent daarom met gewichten die zijn teruggebracht tot 4 bits per parameter, een gemiddelde aanvraag van 256.000 tokens en een KV-cache van 8 bits.
Model verdeeld over wafers
Kimi K3 bestaat uit 69 lagen met linear attention en 24 lagen met volledige attention. Bij de gekozen compressie nemen de modelgewichten gemiddeld ongeveer 16 GB per laag in beslag. Een wafer kan daardoor twee lagen met linear attention bevatten, samen goed voor ongeveer 32 GB.
Lagen met volledige attention krijgen elk een eigen wafer. Daarop moet namelijk ook ruimte beschikbaar blijven voor de KV-cache. Die cache bewaart informatie over tokens uit actieve aanvragen. Voor de 69 lineaire lagen zijn 35 wafers nodig, terwijl de 24 lagen met volledige attention ieder een eigen wafer krijgen. In totaal komt de berekening uit op 59 wafers.
De wafers werken samen als een pijplijn. Iedere wafer voert een deel van het model uit en stuurt alleen de tussenresultaten, de zogenoemde activaties, door naar de volgende wafer. De modelgewichten blijven daarbij in principe op hun oorspronkelijke wafer staan. De verbinding tussen wafers gebruikt RDMA over Ethernet, waarbij een overdracht volgens Cerebras ongeveer 2 microseconden per stap duurt.
Meerdere aanvragen tegelijk
Het systeem verwerkt niet één aanvraag volledig voordat de volgende begint. Terwijl een wafer aan een token van aanvraag A werkt, kunnen andere wafers tegelijk tokens voor aanvragen B en C verwerken. Zo blijft de pijplijn gevuld en kunnen verschillende aanvragen gelijktijdig door afzonderlijke verwerkingsfasen gaan.
Cerebras kan bovendien kleine groepen aanvragen, microbatches genoemd, per fase verwerken. Kleinere groepen verkorten de wachttijd per aanvraag, terwijl grotere groepen de totale doorvoer kunnen verhogen. Het aantal gelijktijdige aanvragen wordt vooral begrensd door de ruimte die op de wafers overblijft voor de KV-cache.
Dezelfde methode kan volgens Cerebras ook worden toegepast op modellen die groter zijn dan 3 biljoen parameters. Extra wafers leveren daarbij zowel meer rekenkracht als extra geheugen op de chip.