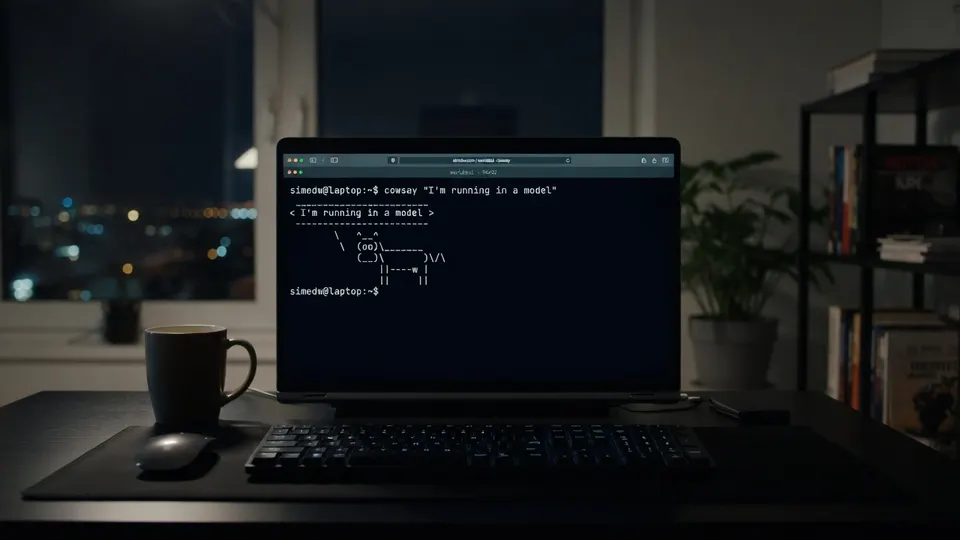
Een taalmodel van 360 miljoen parameters kan zich gedragen als een terminal, zonder dat daarachter een echte shell of een bestandssysteem draait. Elke toetsaanslag wordt verwerkt als invoer, waarna het model voorspelt welke tekens op het scherm veranderen en waar de cursor terechtkomt.
De demonstratie werkt in een desktopbrowser met WebGPU en een fysiek toetsenbord. De browserversie is 208 MB groot. Het model kan onder meer bestanden aanmaken, vim en tmux uitvoeren en het spel Snake spelen. Ook onthoudt het doorgaans wat enkele opdrachten eerder is ingevoerd. Wie in de demo pythoon typt, ziet dat het geen echte shell is.
Terminal als schermrooster
Het model behandelt een terminal als een rooster van tekens. In plaats van telkens een volledige tekststroom te genereren, beschrijft het welke schermregels moeten worden aangepast en wat de nieuwe cursorpositie is. Ook wachten is een invoeractie. Dat maakt het mogelijk dat Snake blijft bewegen wanneer de gebruiker niets doet.
Voor veel handelingen hoeft het model niet alle tekens opnieuw uit te schrijven. Bij het scrollen kan een regel bijvoorbeeld worden gekopieerd naar de regel erboven. Daardoor daalt de hoeveelheid informatie die nodig is voor een schermverschuiving sterk. Het systeem gebruikt in totaal 333 tokens voor tekens, coördinaten en speciale bewerkingen. De uitvoer wordt bovendien beperkt tot geldige schermupdates.
De ontwikkelaar trainde het systeem met terminalsessies uit echte programma's die in Docker-containers draaiden. Daarbij werden toetsenbordinvoer en scherminhoud na elke actie vastgelegd. De gegenereerde sessies bevatten verschillende gebruikers, mappen, bestanden, terminalgroottes en activiteiten, zoals programmeren, bestandsbewerking, Python, vim en tmux. De dataset kwam uit op 336.000 episodes, samen ongeveer 2 miljard tokens.
Model leert fouten herstellen
Als het model tijdens een lange sessie een fout maakt, kan die fout zich aanvankelijk blijven herhalen. Daarom werd het ook getraind op situaties die door zijn eigen voorspellingen ontstonden. Het vergelijkt zijn scherm met de juiste toestand en leert vervolgens een beperkte correctie uit te voeren, zolang de benodigde informatie eerder zichtbaar was of door de gebruiker is ingevoerd.
De uiteindelijke versie is gebaseerd op Qwen2.5-Coder-0.5B en is aangepast voor realtimegebruik. De training en verbeteringen kostten ongeveer 75 gpu-uren op een RTX 4090. Bij een interne test verbeterde de score op PresetBench van 24 van de 47 gevallen naar 38 van de 47 met int4-kwantisatie.